JEV 是什么:从“让模型写答案”到“让软件做决定”#
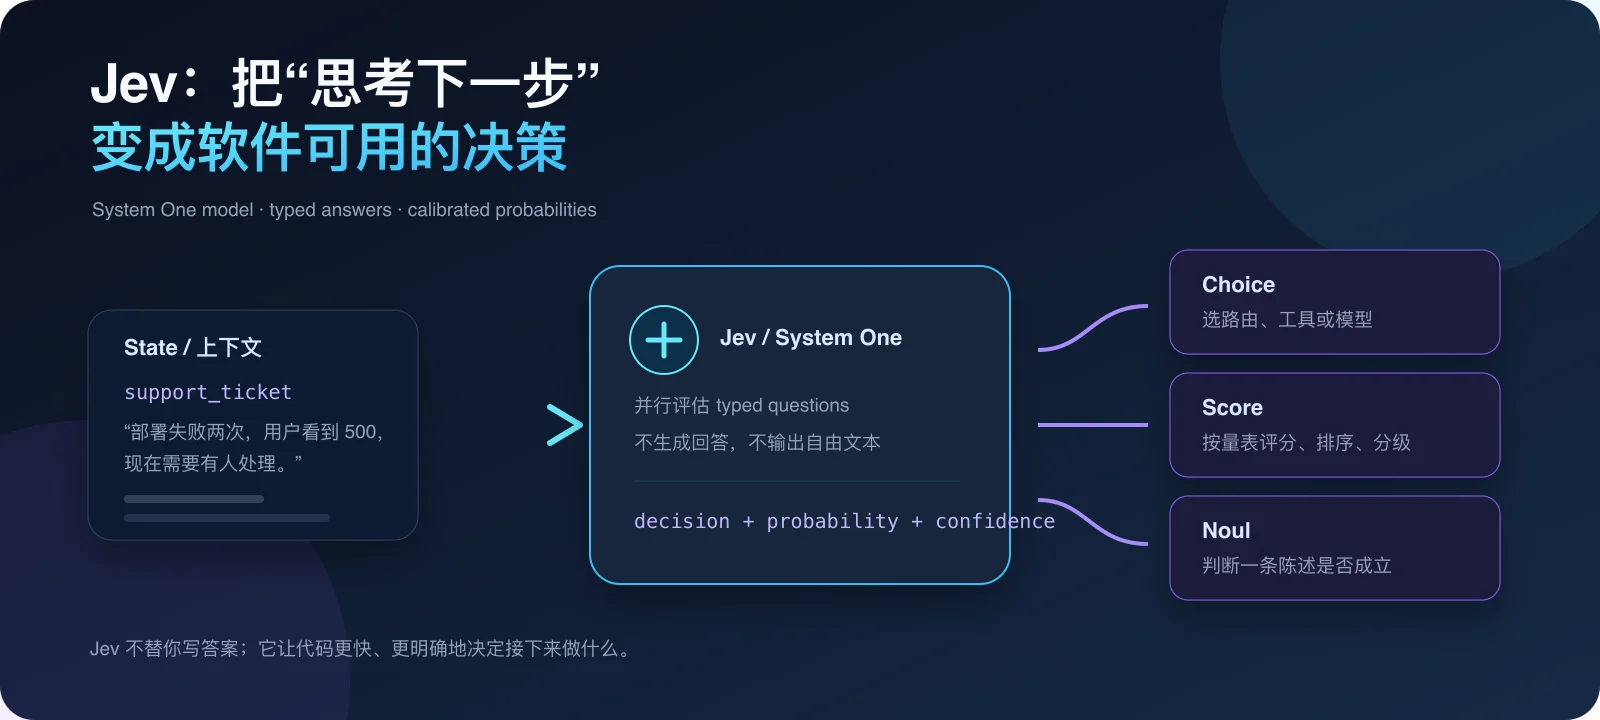
Jev 不是又一个聊天模型。它更像一个可以被程序直接调用的“语义决策函数”:给它一段 state,再给它几个类型化问题,它返回 Choice、Score 或 Noul,以及相应的概率和置信度。

本文基于 TypeSafe AI 的发布文章与官方文档、LangChain 官方集成文档,以及已经公开的开源实践整理。Jev 在 2026 年 9 月仍处于早期访问和快速迭代阶段,模型别名、价格、SDK 接口和集成 API 使用前应再次核对。
先给结论:Jev 解决的不是“写什么”,而是“下一步做什么”#
传统 LLM 的强项是生成:回答问题、写邮件、写代码、解释原因。软件真正需要的另一类能力却更窄,也更频繁:
- 这条工单应该交给 billing 还是 infra?
- 这个请求是否足够复杂,需要升级到更强的模型?
- 这个工具调用是否有风险,是否应该拦截?
- 这段 RAG 片段和用户问题到底相关不相关?
- 一个答案是否覆盖了用户提出的所有要求?
这些任务的结果不是一篇文章,而是一个可以进入 if、switch、路由表或审批流程的判断。
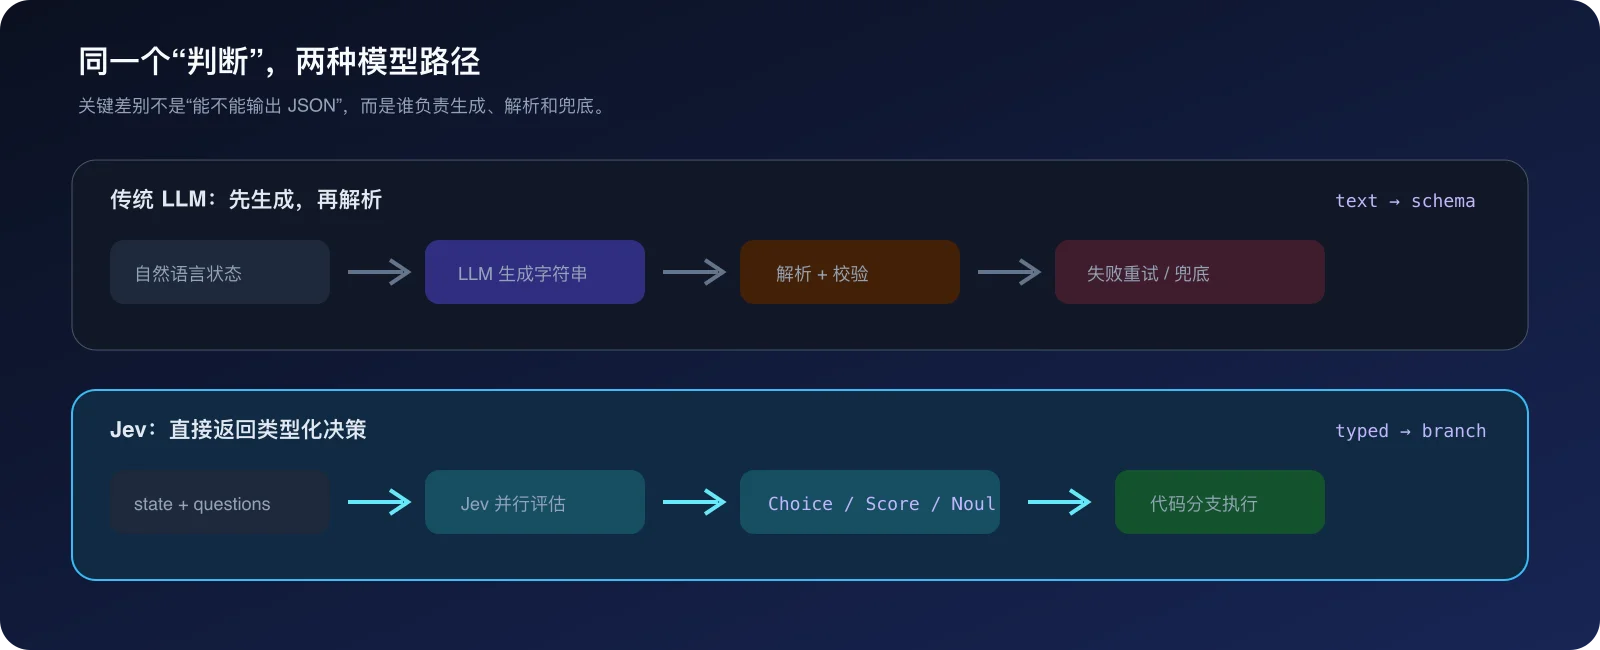
Jev 的基本形状是:
state + typed questions
        │
        ▼
Jev:并行评估多个问题
        │
        ▼
typed answers + probabilities + confidence
        │
        ▼
你的代码决定分支、权限和副作用
这也是 TypeSafe 所说的 System One model:面向软件内部的快速、结构化决策,而不是面向人类阅读的自由文本。官方把 Jev 描述为“输入 state 和类型化问题,直接返回代码可消费的结构化结果”。
1. Jev 和普通 LLM 到底差在哪里#
1.1 普通 LLM:输出字符串,应用再把字符串变成数据#
即使模型支持 JSON mode 或 structured output,典型链路仍然是:
prompt → 生成 token → 解析 JSON → schema 校验 → 失败重试 → 执行这条链路当然有用,但它把一个“选项判断”包装成了完整的文本生成任务。模型要逐 token 生成答案,应用还要处理格式错误、缺失字段、额外解释和不符合业务枚举的值。
1.2 Jev:问题空间先由代码定义,模型只在空间内判断#
Jev 的输入由两部分组成:
state:被判断的上下文,可以是文本、JSON 对象/数组、对话消息或序列化的程序状态。questions:你定义的问题,以及可选答案、评分等级或真假标准。
输出不是“我认为……”,而是类似:
{
  "answers": {
    "team": {
      "type": "choice",
      "choice": "infra",
      "probabilities": {
        "infra": 0.96,
        "billing": 0.03,
        "other": 0.01
      },
      "confidence": 0.93
    }
  }
}
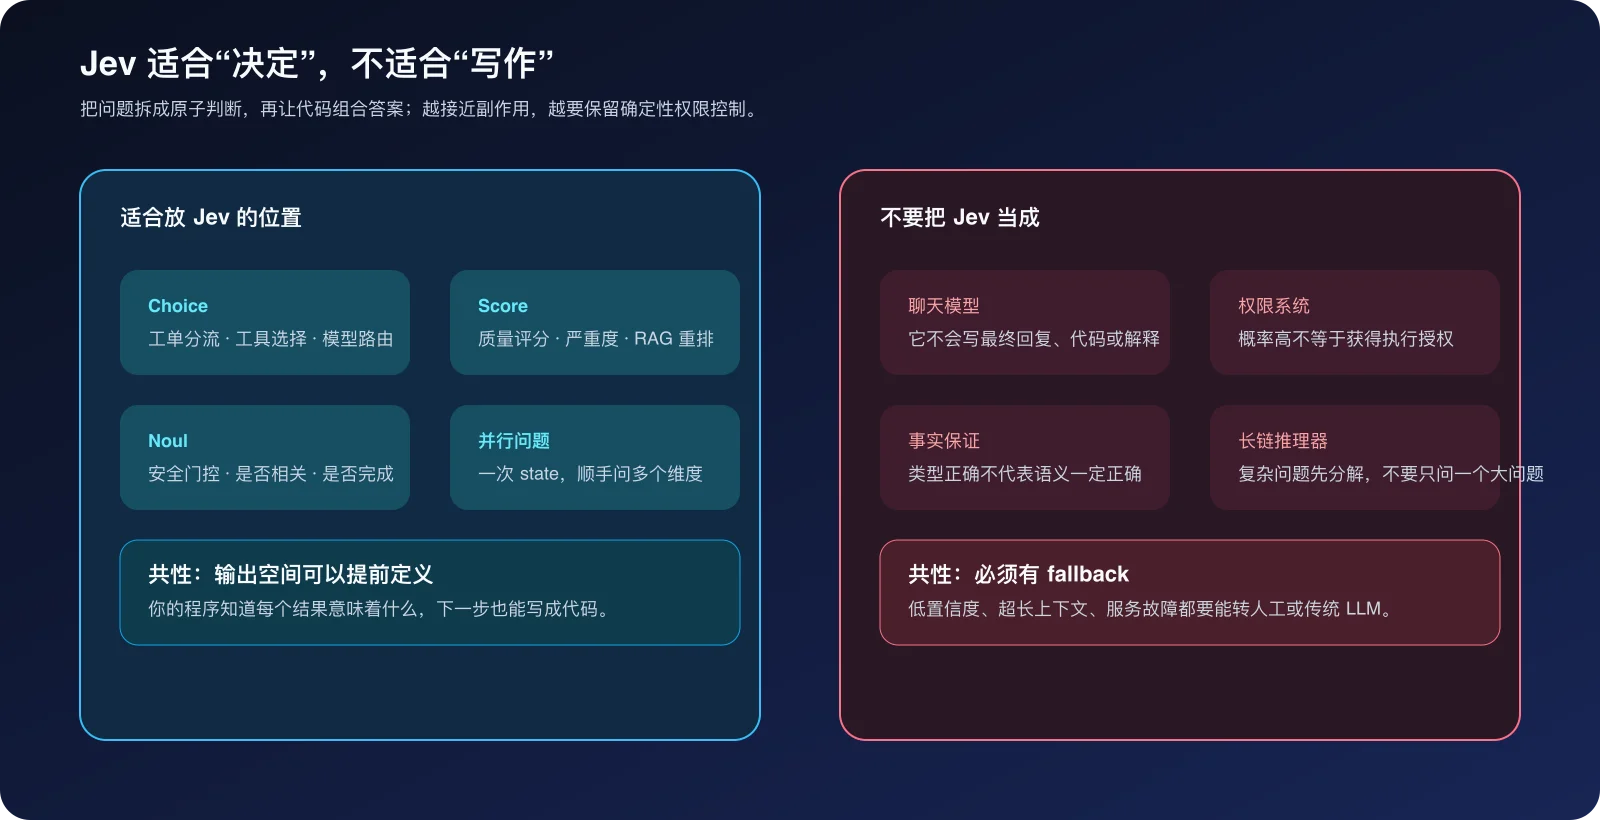
这并不意味着“结构正确就一定判断正确”。它只把格式和语义判断拆成了两个问题:Jev 保证返回已定义的结果形状;你仍然需要用标注数据评估准确率,并为低置信度和服务异常设计 fallback。
TypeSafe 在发布文章中报告了 Jev 在其 System One workflow evals 上的速度和成本优势:端到端约 70ms–500ms,输入价格列为 $0.042 / MTok,并给出最高约 40–200 倍速度、约 400 倍成本差异的主张。这里的数字来自厂商自己的工作流、参考模型和测试设计,适合作为方向性信号,不应当当作你的业务 SLA;真正上线前要用自己的 state、问题定义和 fallback 测量。
1.3 三种基本问题类型#
| 类型 | 你在问什么 | 典型返回 | 适合场景 |
|---|---|---|---|
Choice | 从有限选项中选一个 | choice、每个选项的 probabilities、confidence | 路由、工具选择、意图分类、工单分流 |
Score | 按有序量表给出程度 | score、legend、概率分布、confidence | 严重度、质量、相关性、审核等级 |
Noul | 一条陈述为真的概率是多少 | noul,范围 0..1 | 是否紧急、是否相关、是否含 PII、是否通过门控 |
Noul 是一个专门的真假判断,不是“中等程度”的替代品。比如“是否需要人工审核”适合 Noul;“风险是低、中、高还是严重”适合 Score。
同一次请求可以混合三种类型。官方文档强调,这些问题针对同一个 state 独立并行评估,所以把“队列、严重度、是否紧急”放在一次调用里通常比串行调用更自然。
2. JEV 的最小调用#
2.1 环境变量和接口形状#
TypeSafe 官方 Quickstart 给出的直接接口是:
POST https://api.typesafe.ai/v1/systemone
Authorization: Bearer $TYPESAFE_API_KEY
Content-Type: application/json
它不是 OpenAI Chat Completions 兼容接口。请求里没有 messages,响应里也不是 choices[0].message.content。核心请求体是 model + state + questions。
2.2 用 cURL 做一次多问题判断#
export TYPESAFE_API_KEY="你的 TypeSafe API Key"

curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d @- <<'JSON'
{
  "model": "jev-latest",
  "state": {
    "subject": "部署失败两次,客户看到 500 错误",
    "body": "请尽快处理,线上订单已经受到影响。"
  },
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "哪个团队应该接手这条请求?",
      "criteria": {
        "infra": "部署、可用性、线上事故和服务故障",
        "billing": "付款、账单、订阅和退款",
        "other": "不属于以上两类的问题"
      }
    },
    "severity": {
      "type": "score",
      "instructions": "这次问题的影响有多严重?",
      "criteria": [
        "低:不影响主要功能",
        "中:部分用户受到影响",
        "高:大量用户无法完成核心操作"
      ]
    },
    "urgent": {
      "type": "noul",
      "instructions": "这条消息是否表达了需要立即处理的紧迫性?"
    }
  }
}
JSON
响应大致如下,具体概率会随模型版本和请求变化:
{
  "model": "jev-latest",
  "answers": {
    "team": {
      "type": "choice",
      "choice": "infra",
      "probabilities": {
        "infra": 0.97,
        "billing": 0.01,
        "other": 0.02
      },
      "confidence": 0.95
    },
    "severity": {
      "type": "score",
      "score": 1.86,
      "legend": {
        "0": "低:不影响主要功能",
        "1": "中:部分用户受到影响",
        "2": "高:大量用户无法完成核心操作"
      },
      "probabilities": {
        "0": 0.01,
        "1": 0.12,
        "2": 0.87
      },
      "confidence": 0.88
    },
    "urgent": {
      "type": "noul",
      "noul": 0.99
    }
  }
}
注意 Score 的 score 不是固定的 0..1 概率,它是按有序等级计算出的概率加权位置。上例的 1.86 表示结果更靠近“高”,但仍保留了分布信息。Noul 返回的就是“为真”的概率;官方 LangChain 文档也特别提醒,Noul 不额外返回 confidence。
2.3 用 Python SDK 调用#
官方 Python SDK 的安装和最小写法:
pip install typesafe-sdkfrom typesafe_sdk import Choice, Noul, Score, TypeSafeClient
client = TypeSafeClient()
ticket = {
"subject": "部署失败两次,客户看到 500 错误",
"body": "请尽快处理,线上订单已经受到影响。",
}
response = client.system_one(
model="jev-latest",
state=ticket,
questions={
"team": Choice(
instructions="哪个团队应该接手这条请求?",
criteria={
"infra": "部署、可用性、线上事故和服务故障",
"billing": "付款、账单、订阅和退款",
"other": "不属于以上两类的问题",
},
),
"severity": Score(
instructions="这次问题的影响有多严重?",
criteria=[
"低:不影响主要功能",
"中:部分用户受到影响",
"高:大量用户无法完成核心操作",
],
),
"urgent": Noul(
instructions="这条消息是否表达了需要立即处理的紧迫性?",
),
},
)
team = response.answers["team"]
severity = response.answers["severity"]
urgent = response.answers["urgent"]
print(team.choice, team.confidence)
print(severity.score)
print(urgent.noul)工程上更重要的部分是调用之后的策略,而不是把概率打印出来:
if team.confidence < 0.85 or severity.confidence < 0.85:
    send_to_human_review(ticket)
elif urgent.noul >= 0.90:
    page_on_call(team.choice)
else:
    enqueue_for_normal_handling(team.choice)
上面的阈值只是示例,不能直接复制到生产环境。正确阈值应根据你自己的标注集、误判代价和人工容量测出来:退款、删除数据、下单这类不可逆动作,阈值和审批策略应明显更保守。
3. 在 LangChain 中怎么用#
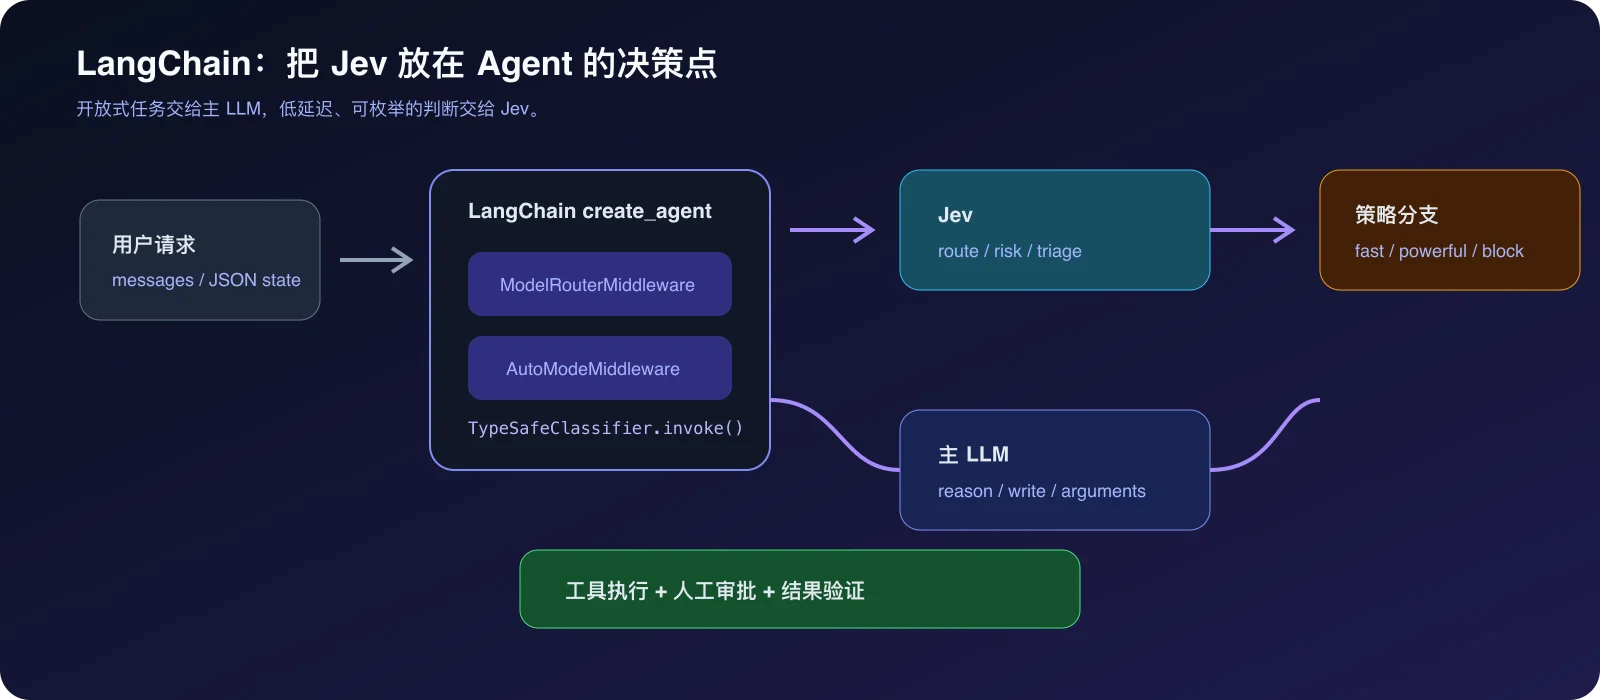
LangChain 的定位很清楚:TypeSafeClassifier 把 Jev 暴露为一个 Runnable,可以 invoke、batch,也可以放进 Agent middleware。Jev 负责受限的判断,主 LLM 仍然负责开放式推理、生成回复和补齐工具参数。
3.1 安装与最小 Runnable#
pip install langchain-typesafe
export TYPESAFE_API_KEY="你的 TypeSafe API Key"
最推荐从“固定问题集”开始:
from langchain_typesafe import Choice, Noul, Score, TypeSafeClassifier

classifier = TypeSafeClassifier(
    questions={
        "urgent": Noul(
            instructions="这条请求是否需要立即处理?",
        ),
        "team": Choice(
            instructions="哪个团队应该接手?",
            criteria={
                "infra": "部署、可用性和线上事故",
                "billing": "付款、发票和订阅",
            },
        ),
        "severity": Score(
            instructions="影响有多严重?",
            criteria=[
                "仅轻微影响",
                "部分用户受影响",
                "核心流程大面积中断",
            ],
        ),
    }
)

response = classifier.invoke(
    "部署失败两次,客户看到 500 错误。请尽快处理。"
)

print(response.nouls["urgent"].noul)
print(response.choices["team"].choice)
print(response.choices["team"].confidence)
print(response.scores["severity"].score)
invoke 的 state 也可以是 JSON 对象、数组或 LangChain message。这样一来,Jev 可以直接放在已有 Agent 节点、middleware 或工具前面,不需要先把消息“改写成一段 prompt”。
3.2 模型路由:简单请求走快模型,复杂请求走强模型#
一个常见的 Agent harness 是:先判断任务复杂度,再选择模型。对于简单查找、抽取和局部修改,不必每次都使用最贵的推理模型;对于架构设计、根因分析和高风险决定,再升级到强模型。
LangChain 官方的 TypeSafe 集成提供了实验性 ModelRouterMiddleware:
pip install "langchain-typesafe[experimental]" langchain-openaifrom langchain.agents import create_agent
from langchain_typesafe.experimental.middleware import (
ModelChoice,
ModelRouterMiddleware,
)
router = ModelRouterMiddleware(
choices={
"fast": ModelChoice(
model="openai:gpt-5.6-terra",
criteria="直接查找、信息抽取、目标明确的局部修改。",
),
"powerful": ModelChoice(
model="openai:gpt-6-astra",
criteria="架构设计、新颖的根因分析和高风险决定。",
),
},
instructions="选择能够安全完成任务的最低成本模型。",
)
agent = create_agent(
"openai:gpt-5.6-terra",
middleware=[router],
)
result = agent.invoke({
"messages": [{
"role": "user",
"content": "解释一下这个函数为什么在空列表时返回错误。",
}]
})
print(result["model_route"].choice)路由只是“建议下一条模型路径”,不是权限系统。你仍然需要限制可用模型、预算、数据出境和高风险任务的人工确认。
3.3 工具风险门控:在工具真正执行之前拦截#
另一个很适合 Jev 的位置是 tool call 前的风险判断。比如 Agent 有 bash、数据库写入、发送邮件或删除备份的工具时,可以在执行前提出一个明确的真假问题:这个调用是否危险、是否缺少授权、是否违反当前任务边界?
LangChain 官方集成中的 AutoModeMiddleware 示例:
from langchain.agents import create_agent
from langchain_typesafe.experimental.middleware import AutoModeMiddleware

guardrail = AutoModeMiddleware(tools=["bash"])

agent = create_agent(
    "openai:gpt-5.6-terra",
    middleware=[guardrail],
)
官方说明里,风险工具调用会被拦截并返回 ToolMessage,而不是直接运行工具。这里有三个边界必须保留:
- Jev 的“风险判断”不能代替操作系统权限、数据库权限和 allowlist。
- Jev 的高概率不能自动授予执行授权,尤其不能授权不可逆动作。
- 如果要让用户确认,应再接 LangChain 的 human-in-the-loop 机制;
AutoModeMiddleware本身负责判断和拒绝,不负责向用户发起审批。
3.4 自定义 middleware:把 Jev 结果写入 Agent state#
当内置 middleware 不够用时,可以在 before_agent、before_model 或 wrap_tool_call 等生命周期点调用 TypeSafeClassifier,把完整 answer 放进 Agent state:
from typing_extensions import NotRequired

from langchain.agents import create_agent
from langchain.agents.middleware import AgentMiddleware, AgentState, Runtime
from langchain_typesafe import Choice, ChoiceAnswer, TypeSafeClassifier


class TriageState(AgentState):
    triage: NotRequired[ChoiceAnswer]


class TriageMiddleware(AgentMiddleware[TriageState]):
    state_schema = TriageState

    def __init__(self) -> None:
        self.classifier = TypeSafeClassifier(
            questions={
                "triage": Choice(
                    instructions="哪个团队应该处理这段对话?",
                    criteria={
                        "billing": "付款、发票和订阅",
                        "infra": "部署、可用性和线上事故",
                        "other": "其他请求",
                    },
                )
            }
        )

    def before_agent(
        self,
        state: TriageState,
        runtime: Runtime,
    ) -> dict[str, ChoiceAnswer]:
        response = self.classifier.invoke(state["messages"])
        return {"triage": response.choices["triage"]}


agent = create_agent(
    "openai:gpt-5.6-terra",
    middleware=[TriageMiddleware()],
)
这段代码的价值不在于“又做了一次分类”,而在于把分类结果变成 Agent runtime 的显式状态。后面的模型、工具和观测系统都可以知道:本次运行被分到了哪个队列、置信度是多少、是否应该走某个分支。
4. 已经出现的使用案例#
下面分成两类:第一类是官方或开源仓库已经明确展示的做法;第二类是根据 Jev 的 primitives 推导出的落地场景。后者是架构建议,不等于 TypeSafe 官方承诺或准确率保证。
4.1 工单分流、严重度和紧急度#
这是最容易开始的案例:同一个 support ticket,一次并行询问:
Choice:billing、infra、sales 还是 other?Score:影响是低、中、高还是严重?Noul:是否表达了明确紧迫性?
代码根据结果把工单放入队列、通知 on-call,低置信度则送人工。它比单独写三个分类器更容易统一 state,也比让 LLM 写一段“请分配到 infra,理由是……”更适合直接进入程序。
4.2 模型路由与 Agent 预算控制#
LangChain 的公开集成把 Jev 放到了 ModelRouterMiddleware。这个模式可以扩展为:
请求
  ├─ 简单查找 / 抽取 → 快模型
  ├─ 多步推理 / 代码修改 → 普通模型
  └─ 架构 / 高风险问题 → 强模型或人工
真正的收益不是“永远选便宜模型”,而是把模型选择规则、置信度、升级路径和成本预算写成可以观测和评估的 runtime 行为。
4.3 工具选择与危险动作拦截#
在工具很多的 Agent 里,可以先让 Jev 从有限工具集合中选下一步;让主 LLM 只为胜出的工具生成参数。这样可以避免每轮都把几十个工具 schema 全部塞进一个长 prompt。
危险动作则是另一条分支:先判定“是否有风险 / 是否缺少授权”,再由程序决定拒绝、请求审批或执行。注意:Jev 只能提供语义判断,不能替代工具的参数校验、权限校验、沙箱和审计。
4.4 Browser Use:让 Jev 选择浏览器下一步动作#
Browser Use 的开源项目 jev-ultrafast 展示了一个非常直观的组合:
- 浏览器 harness 读取当前页面的可见 DOM 控件,并为动作和元素建立索引。
- Jev 在一个受限动作空间中选择“点击哪个元素、输入哪类操作、滚动、等待或结束”。
- 只有需要生成实际文字时,才调用一个小型 LLM;执行本身由浏览器代码完成。
- 执行前重新校验页面和目标,避免把模型输出直接当成 selector 或 JavaScript。
仓库 README 报告了一个 Google Flights 演示:从 Zürich 到 London 的路径约 7.1 秒。这个数字是单个公开 demo 的作者测量,不应外推成所有浏览器任务的通用 benchmark;但它很好地说明了 Jev 的价值:把“下一步点击什么”从开放式视觉推理改造成闭集决策。
4.5 邮件、欺诈与批量分流#
LangChain 的文章提到社区已经在尝试邮件 triage;社区案例目录还记录了邮件分类和“Jev + Kimi 的欺诈检测”实验。这些是作者报告的项目,应该和官方产品能力区分开看。
从架构上看,邮件和欺诈检测适合这种流水线:
批量消息
  ↓
Jev:类别 + 风险分数 + 是否需要人工
  ↓
高置信度 → 自动进入队列
低置信度 → 交给更强模型或人工
  ↓
最终动作仍由业务规则和权限系统执行
这类任务的关键不是盲目追求一个“最高准确率”数字,而是利用概率进行分层:清晰样本自动化,边界样本升级,失败样本可回放。
4.6 RAG 重排、回答校验和内容审核#
这是很适合自己尝试的三个方向:
- RAG 重排:对每个候选 passage 问“它是否真正回答了问题”,而不是只依赖 embedding 相似度。
- 回答校验:对 draft answer 并行询问“是否覆盖每个要求、是否包含未经证实的绝对表述、是否泄露 PII”。
- 内容审核:用
Score做严重度,用Noul做具体政策命中,再由规则决定隐藏、降权、人工审核或放行。
这里最重要的设计原则是“拆成多个原子问题”。不要直接问:“这篇文章是否高质量?”更好的方式是分别问:是否回答主题、证据是否充分、是否存在绝对化表述、是否符合风格,再由代码用业务权重组合。
5. 如何设计一个靠谱的 Jev 问题#
Jev 的 instructions 和 criteria 不是装饰,它们就是判断边界。可以用下面的检查表:
问题要原子化
坏问题:
这条工单是否重要、紧急、值得升级并且应该交给资深工程师?好问题:
是否表达了需要立即响应的时间压力?       → Noul
对线上用户的影响有多严重?               → Score
哪个团队拥有处理它的主要职责?             → Choice
选项要互斥、覆盖“其他”和“不确定”
Choice 的选项描述决定了模型如何理解类别。如果“billing”和“account”在你的业务里经常重叠,就不要只改标签;要在 criteria 里写清边界,必要时加入 other 或 needs_review。
先输出概率,再设计阈值
不要把 choice 当成永远正确的答案。更稳妥的程序通常是:
answer = response.choices["team"]

if answer.confidence >= 0.90:
    route(answer.choice)
else:
    send_to_review()
阈值应在自己的历史流量上调参。一个支付系统和一个低风险内容标签器,不应该共享同一个默认阈值。
把授权与执行留在代码里
模型可以判断“这次删除请求看起来危险”,但它不应拥有删除权限。应用仍应使用明确的 allowlist、用户身份、资源权限、幂等键、审批和审计日志。
6. JEV 的边界与工程注意事项#
它不生成最终文本
如果任务是写邮件、生成代码、解释答案、总结长文,仍然需要传统 LLM、模板或确定性程序。Jev 最适合作为它们前面的路由器、过滤器、校验器和门控层。
它不保证事实正确
类型安全解决的是输出形状,不是事实真值。Choice 返回一个合法枚举,也可能选错;Noul 返回 0.99,也不等于你的业务可以跳过验证。
概率需要校准和回放
TypeSafe 宣称使用 RLCD(Reinforcement Learning for Calibrated Decisions)训练,目标是让概率更接近长期频率。但“校准”是统计属性,不是对单个样本的保证。生产系统应记录输入摘要、问题版本、模型版本、结果、置信度、最终人工标签和实际后果,用这些数据做离线评估。
上下文和模态有限制
当前公开文档以文本为主,JSON 和 LangChain messages 会被序列化为可判断的 state;图片、音频和视频不是公开 API 的直接输入形态。视觉任务应先用视觉模型或工具提取结构化描述,再把描述交给 Jev。
仍然需要 fallback#
至少准备三条 fallback:
- 低置信度:人工审核或更强 LLM。
- API 超时 / 故障:传统规则、队列暂停或 LLM-only 路径。
- 上下文过长 / 问题不适合:先摘要、缩小 state,或直接交给能做长链推理的模型。
7. 一个实用的落地顺序#
如果要在现有 Agent 里试 Jev,可以按这个顺序:
- 只选一个低风险、可标注的判断,例如工单队列或内容是否相关。
- 先用
Choice、Score、Noul写出清晰问题,不要一开始做复杂 workflow。 - 收集真实流量和人工标签,检查概率是否能用于分层。
- 把低置信度样本送人工,确认收益来自实际准确率而不是 demo 观感。
- 再把 Jev 放进 LangChain middleware,做模型路由或工具风险门控。
- 最后才考虑浏览器、交易、删除、发送等高副作用场景,并补齐权限、审批、回放和独立完成校验。
总结
Jev 的核心思想可以压缩成一句话:
不要为了得到一个
if条件,让通用 LLM 先写一段话,再让程序把这段话解析回来。
当问题的答案可以提前定义为有限选择、评分量表或真假概率时,Jev 提供了一个更贴近软件的接口:state → typed decision → code branch。
它最有价值的地方,不是替换 LLM,而是把 Agent harness 中那些高频、短路径、可枚举的判断独立出来:模型路由、工具选择、风险门控、工单分流、RAG 重排和结果校验。开放式推理仍然交给主 LLM,权限、执行和最终责任仍然由你的程序与人来承担。
参考资料与进一步阅读
官方资料
- TypeSafe AI:Introducing System One Models & Jev —— System One、RLCD、性能与成本主张。
- TypeSafe AI 官方文档:Introduction —— Jev、三种 primitive、并行问题和原子化判断。
- TypeSafe AI 官方文档:Quick start —— Playground、cURL、Python SDK 与请求/响应示例。
- LangChain:Building a Harness with Jev —— Jev 在 Agent loop、模型路由和 Auto Mode 中的定位。
- LangChain 官方文档:TypeSafe integrations ——
TypeSafeClassifier、middleware、LangSmith tracing。
开源与社区实践
- Browser Use:jev-ultrafast —— 将 Jev 用于索引化浏览器动作选择的开源 Agent。
- Simple Jev demos —— 客服分流、产品评价、社区审核、2048 和浏览器自动驾驶等演示。
- Made with Jev:Agents and browsers —— 浏览器 Agent 和公开项目索引;其中的性能数字均应回到作者仓库或原帖核对。
- Made with Jev:Triage and routing —— 邮件分流、欺诈检测等社区报告;这些是作者报告的实验,不是官方 benchmark。